운영 문서에서 IP·호스트명·계정·자격증명을 제거한 버전. 노드는 node1~node4로 표기.
계기 — 캡이 풀려 있었다
3일치 텔레메트리에서 SoC(ACPI 열영역) 최고값이 **93℃**를 찍은 구간을 발견했다. 평소는 40℃대인데 한 구간만 튀었다. 추적해 보니:
- 그 시각은 head(node1) vLLM 컨테이너가 크래시 후 워치독으로 재기동된 직후였다.
- head GPU가 리셋되면서
nvidia-smi -lgc 0,2000으로 걸어둔 2000MHz 클럭 락이 풀렸다. 부팅 시 캡을 거는 서비스는 oneshot이라 재기동 후 다시 걸어주지 않는다. - 워커 3노드는 리셋되지 않아 캡이 유지됐고, 같은 시간대에도 정상 온도였다.
즉 93℃는 “서빙이 뜨거워서"가 아니라 head 한 대의 GPU가 무제한으로 돌며 재기동 부하를 받은 결과였다. 즉시 캡을 다시 걸고, 리셋으로 캡이 날아가도 5분 안에 다시 거는 재적용 타이머(user systemd)를 심었다.
여기서 자연스러운 질문이 나왔다. 클럭 캡은 정확히 무엇을 얻고 무엇을 잃는가? 그래서 통제 실험을 했다.
두 개의 레버
이 플랫폼에는 두 개의 클럭 캡이 있다.
- GPU 클럭 캡 (
nvidia-smi -lgc 0,2000): GPU 스트리밍 멀티프로세서 클럭 상한. - CPU 클럭 캡 (
scaling_max_freq): CPU 코어 클럭 상한. GB10은 CPU·GPU가 한 다이에 있는 통합 SoC다.
세 조건을 만들었다: Uncapped(둘 다 해제) / GPU 2GHz(GPU만 2000MHz) / GPU+CPU 2GHz(둘 다). 각 조건을 동시성 32(처리량 구간)와 단일스트림(대화형 구간) 두 부하에서 측정했다. 부하 중 1초 간격으로 GPU 온도·전력·클럭과 SoC ACPI 열영역 최고값을 전 노드에서 샘플링했다. 처리량은 vLLM 서버의 생성 토큰 카운터 증분으로 측정해 클라이언트 병목을 배제했다.
동시성 32 (처리량 구간)
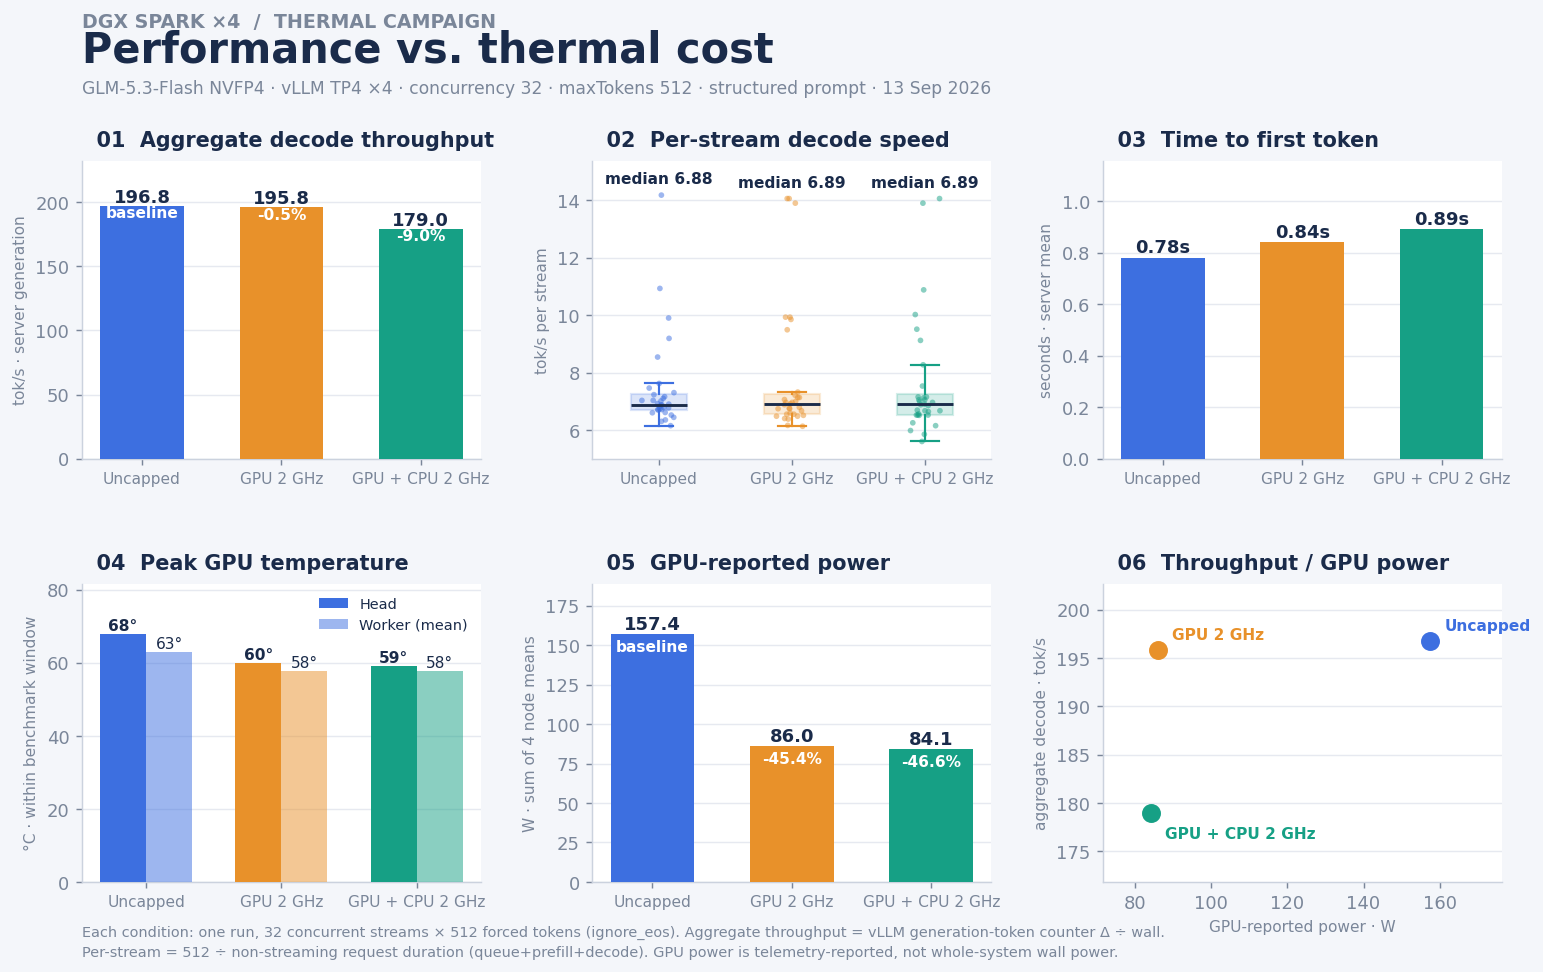
| 조건 | 합산 처리량 | Head GPU℃ | GPU 전력(4노드 합) |
|---|---|---|---|
| Uncapped | 196.8 tok/s | 68 | 157.4 W |
| GPU 2GHz | 195.8 (−0.5%) | 60 | 86.0 W (−45%) |
| GPU+CPU 2GHz | 179.0 (−9.0%) | 59 | 84.1 W (−47%) |
- GPU 캡은 사실상 공짜였다. 처리량 −0.5%인데 GPU 전력이 45% 줄고 온도가 8℃ 내려갔다. 동시성 32에서 GPU 클럭은 처리량의 병목이 아니다 — uncapped가 2500MHz로 돌아도, 캡으로 2000MHz에 묶여도 처리량은 같다. 병목은 메모리 대역폭과 노드 간 통신이다.
- CPU 캡을 더하면 처리량이 9% 빠졌다. 배치 구간인데도 그랬다.
단일스트림 (대화형 구간)
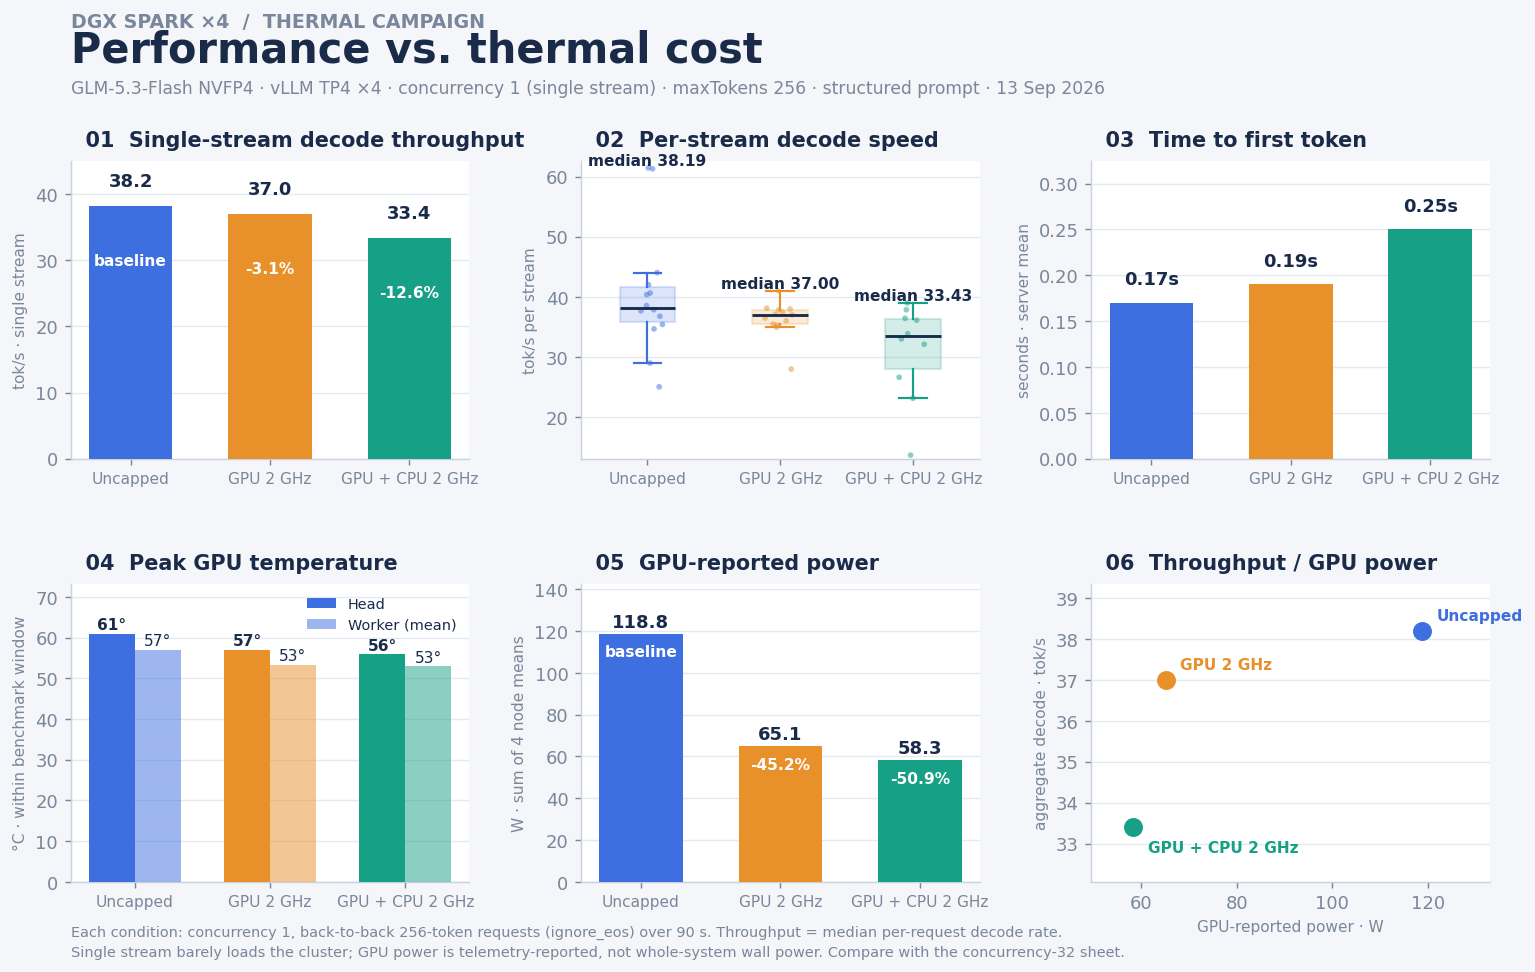
| 조건 | 디코딩 속도 | Head GPU℃ | GPU 전력(4노드 합) |
|---|---|---|---|
| Uncapped | 38.2 tok/s | 61 | 118.8 W |
| GPU 2GHz | 37.0 (−3.1%) | 57 | 65.1 W (−45%) |
| GPU+CPU 2GHz | 33.4 (−12.6%) | 56 | 58.3 W (−51%) |
- GPU 캡은 여기서도 거의 무영향(−3.1%). 단일스트림 디코딩은 스텝 지연에 묶여 있고, 그 지연은 GPU 클럭이 아니라 CPU의 커널 런치·파이썬 오버헤드가 지배한다.
- CPU 캡은 −12.6%. 이 구조화 프롬프트 기준이고, 콘텐츠에 따라(코드 생성 등 예측성이 낮은 출력) 최대 −49%까지 떨어졌다. 대화형 체감을 직접 갉아먹는다.
- 단일스트림은 부하가 가벼워 전력이 동시성 32의 절반 이하다(118 vs 157W).
핵심 발견 — 두 캡은 서로 다른 열을 잡는다
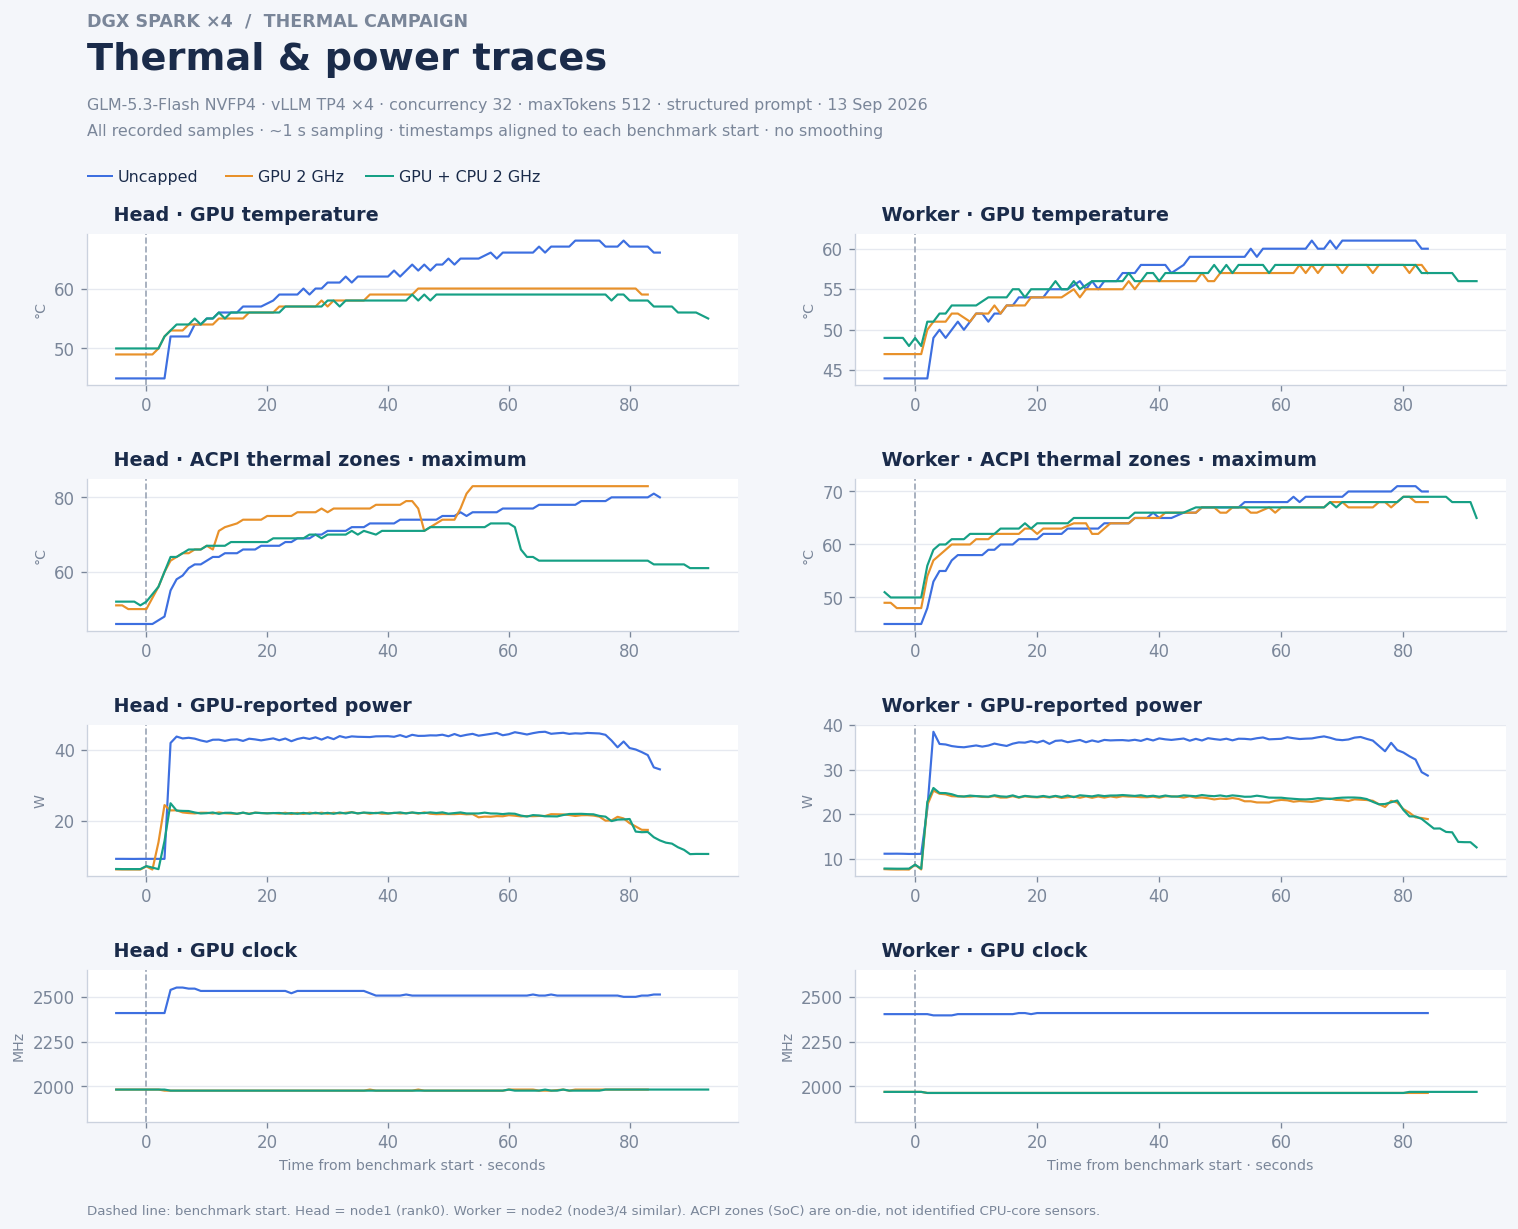
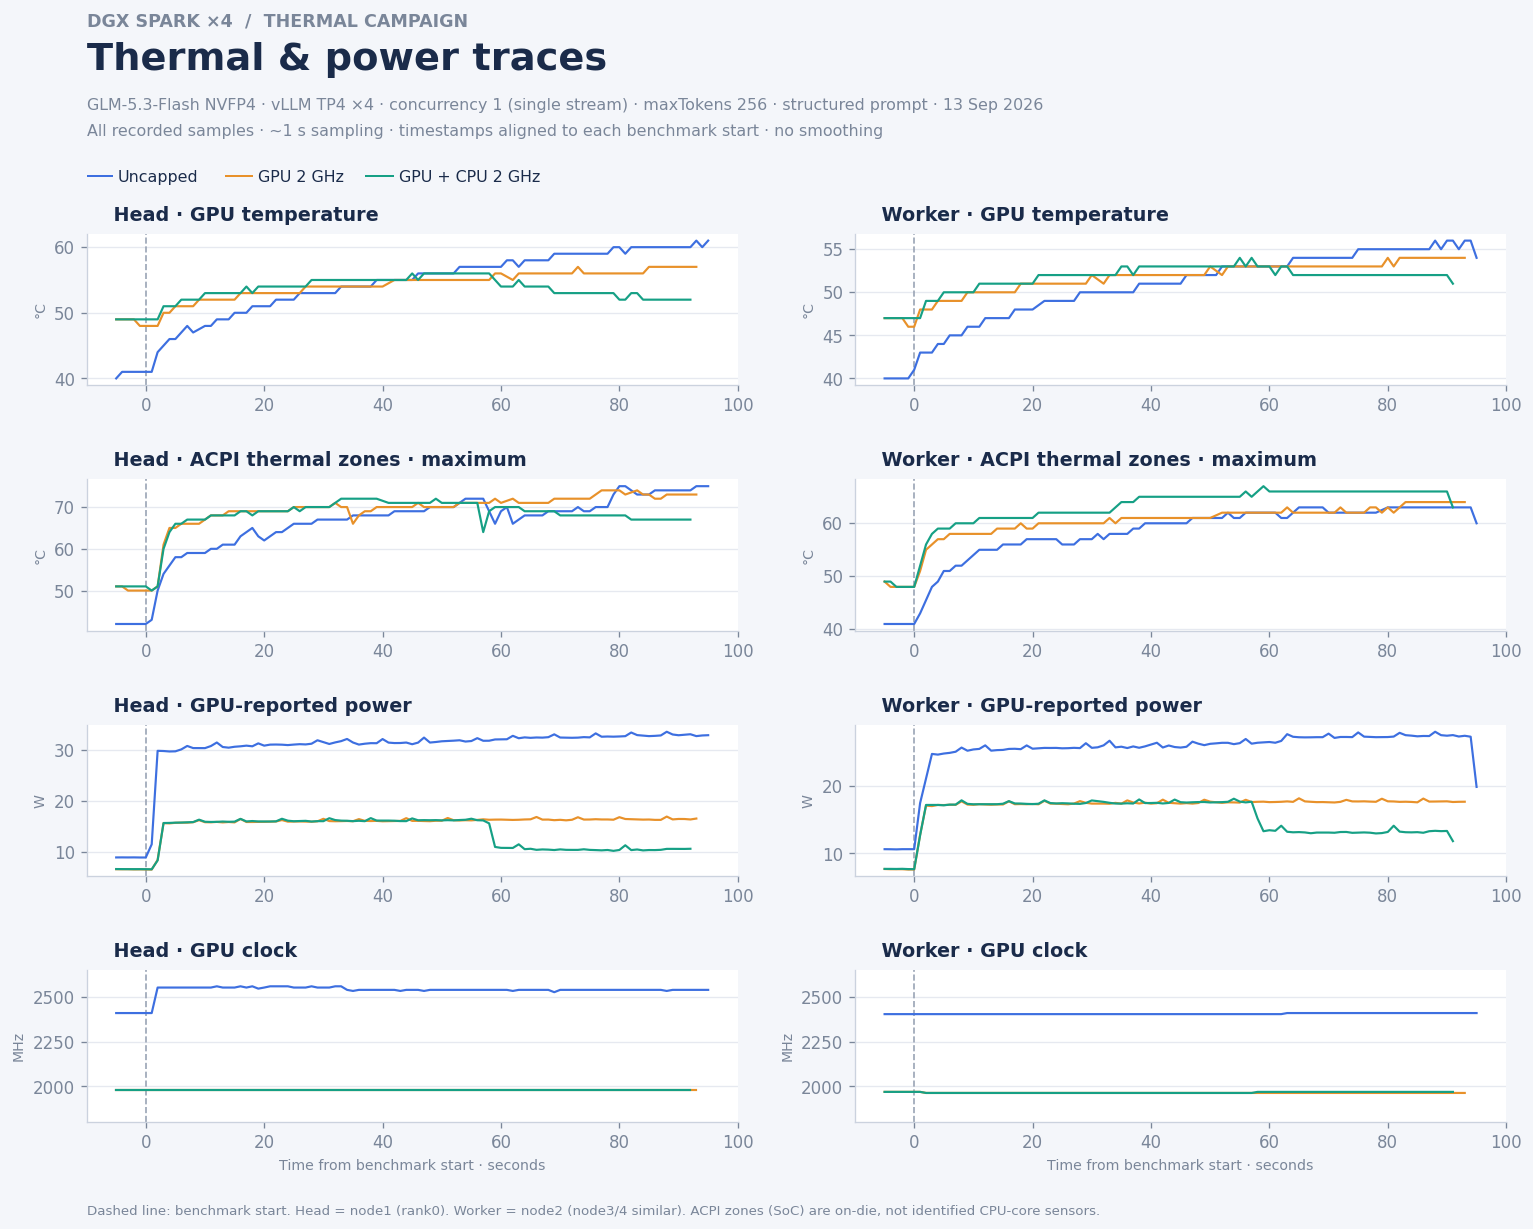
트레이스의 ACPI 열영역 패널이 결정적이다.
- SoC 핫스팟(ACPI 열영역)은 GPU 캡으로 내려가지 않는다. uncapped와 GPU 캡이 80℃대에서 겹친다. 이 열은 GPU가 아니라 CPU 활동에서 나온다.
- CPU 캡만이 SoC 핫스팟을 내린다. 단 그 효과는 head(rank0 + API + 스케줄링을 맡는 노드)에 집중되고, 워커는 GPU-bound라 거의 변화가 없다.
- GPU 정션 온도와 전력은 반대로 GPU 캡이 지배하고 CPU 캡은 거의 영향이 없다.
즉 GPU 캡 → GPU 온도·전력, CPU 캡 → head의 SoC 핫스팟. 두 레버는 각자 다른 것을 잡는다.
결론
| 캡 | 동시성 32 속도 | 단일스트림 속도 | 전력 |
|---|---|---|---|
| GPU 2GHz | −0.5% | −3.1% | −45% |
| +CPU 2GHz | −9.0% | −12.6% (코드 −49%) | 추가 이득 미미 |
- GPU 캡은 상시 필수다. 두 구간 모두 속도 손실이 거의 없으면서 전력을 45% 깎고 온도를 낮춘다. 예전에 확인한 전력 스파이크·하드 파워오프 방어까지 감안하면 끄지 않을 이유가 없다. 그래서 재기동으로 캡이 풀려도 자동으로 다시 걸리게 만들었다.
- CPU 캡은 우리 구성(NVFP4 / vLLM eager)에서는 함정이다. 배치든 대화형이든 속도만 잃고, 전력 추가 이득은 미미하며, SoC 온도도 이미 throttle(약 100℃+)과 거리가 멀다. SoC 핫스팟이 정말 문제인 특수 상황에서 head에 한시적으로 거는 정도가 전부다.
가장 값싼 최적화는 종종 “안 건드리는 것"이다. 단, 건드리지 않기로 한 것이 실제로 그 상태인지 telemetry로 확인해야 한다. 우리의 GPU 캡은 조용히 풀려 있었고, 텔레메트리가 없었다면 몰랐을 것이다.