운영 문서에서 IP·호스트명·계정·자격증명을 제거한 버전. 노드는 node1~node4로 표기. 측정은 2026-09-17 23:00 ~ 09-18 10:30 KST, 모든 값은 이 클러스터 한 구성의 실측이며 일반화하지 말 것.
요약
- 처리량: 한국어 실프롬프트 단일 스트림 12~13 tok/s, 동시 32에서 집계 145 tok/s. 병목은 드래프터 수용률(한국어 20%)과 ~185 ms의 TP=4 검증 스텝. 드래프트 길이 k=7→3으로 줄이면 단일 −12%, 동시 32 +18%(171 tok/s).
- 프리필: 32k 입력 TTFT 20초, 128k 60초. 긴 문서 RAG의 사용성 한계는 여기.
- 정확도(thinking OFF): MMLU 87.9 / MMLU-Pro 77.6 / KMMLU 64.5 / KorMedMCQA 85.4 / MedQA 86.3 / GSM8K 94.5 / HumanEval 75.0. 영어↔한국어 22%p 격차, 의사 국시는 높음.
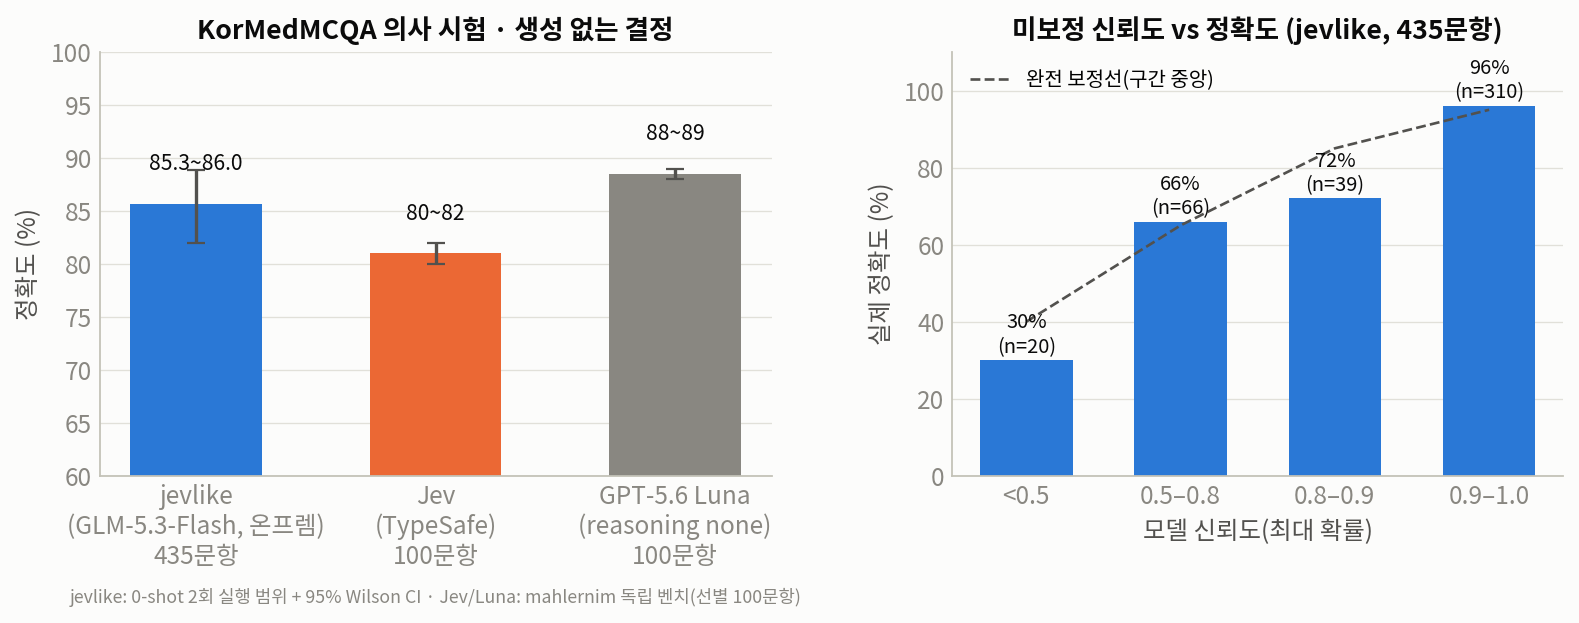
- 생성 없는 결정(jevlike): 첫 토큰 logit만 읽는 방식으로 KorMedMCQA 의사 435문항 85
86% — 같은 모델의 5-shot 생성(83.9)보다 높고, TypeSafe Jev 독립 벤치(8082)보다 높다. 417 ms/건, 미보정 신뢰도가 정확도와 단조. temperature 0에서도 3.4%는 실행마다 답이 바뀐다. - 운영: 9.5시간 연속 부하에 크래시·워치독 오탐·스로틀 0. GPU 63~66℃, head CPU 82℃.
- 삽질: vLLM
stop4개 제한, HumanEval chat 모드 채점 함정(17% vs 75%), thinking 기본값은 서버 인자에 있음.
구성
- 서빙: GLM-5.3-Flash NVFP4(RedHatAI compressed-tensors, ~185GB) + DFlash2 드래프터, vLLM 커스텀 이미지(sm121), 4노드 TP=4, RoCE 200G, fp8 KV 16GiB, 컨텍스트 1M,
--enforce-eager, GPU 클럭 2000MHz 캡. - 서버 기본값이
enable_thinking: false— 아래 모든 수치는 thinking OFF다. 이걸 벤치 중간에야 확인했다(교훈 1). - 클라이언트: 서빙 이미지와 같은 이미지로 CPU 전용 컨테이너를 하나 더 띄워(
--network host, GPU 미할당) 그 안에서vllm bench serve와lm_eval을 실행했다. 서빙 컨테이너는 건드리지 않고, GPU 경합 방지 데몬(gpu-guard)에도 걸리지 않는다.--tokenizer를 모델 로컬 경로로 지정해야 HF 접속 없이 돈다. - 워치독(1토큰 합성 프로브, 120s×3연속 실패 시 재기동)은 disarm하지 않았다. 동시성 32·128k 프리필·밤샘 eval 내내 오탐 0.
1. 처리량 — 한국어 실프롬프트
프롬프트 20종(재활의학 판독·기획실 보고서·인프라 코드 등, 한국어 위주), 출력 512토큰 고정(--ignore-eos).
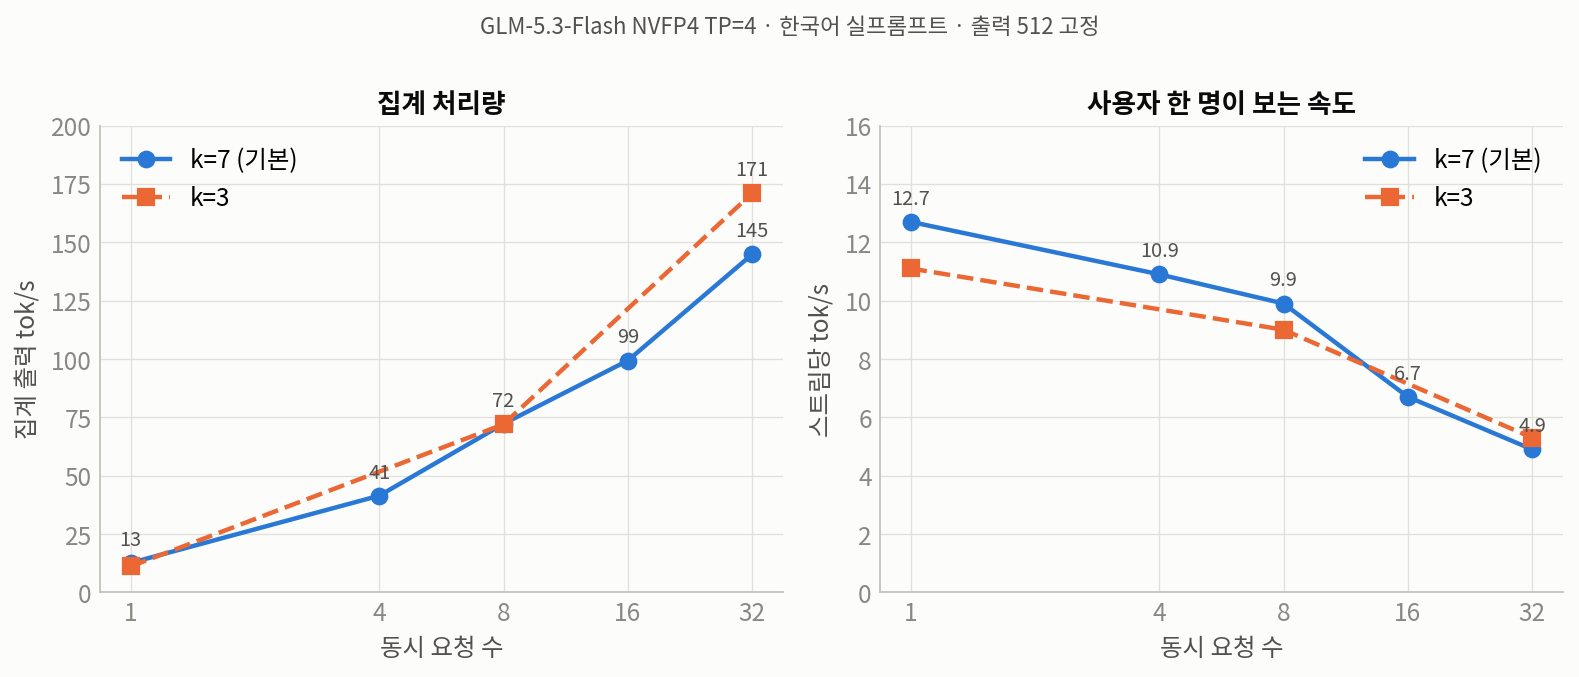
| 동시성 | 집계 tok/s | 스트림당 tok/s | TTFT p50 | ITL p50 |
|---|---|---|---|---|
| 1 | 12.6 | 12.7 | 427 ms | 185 ms |
| 4 | 41.4 | 10.9 | 759 | 214 |
| 8 | 72.2 | 9.9 | 805 | 226 |
| 16 | 99.3 | 6.7 | 1,111 | 340 |
| 32 | 144.8 | 4.9 | 1,517 | 477 |
- 단일 스트림 12
13 tok/s. 이전 글들의 코드 프롬프트 5060 tok/s와 다른 이유는 드래프터 수용률이다. 한국어 산문에서 DFlash2(k=7)의 수용률은 20%, 스텝당 2.4토큰. 검증 스텝 하나가 ~185ms라 12 tok/s가 나온다. 랜덤 토큰 입력이면 10%까지 떨어져 9 tok/s. --ignore-eos탓인지 확인하려고 EOS를 허용한 세트도 돌렸다 — 답변이 512 상한까지 차서(평균 488토큰) 10.2 tok/s로 같았다. 강제 생성 문제가 아니다.- 프리필: 32k 입력 TTFT 20.5초(≈1,600 tok/s), 128k 입력 60.3초(≈2,170 tok/s). 긴 문서 RAG에서 사용성을 결정하는 건 디코드가 아니라 이 TTFT다.
드래프터 k=7 → 3
한국어 수용률이 낮으니 드래프트 길이를 줄이면 검증 낭비가 줄 것이라는 가설. 4노드 런처만 바꾸고 워치독이 재기동하게 뒀다(부팅→health 18.5분).
| k=7 | k=3 | |
|---|---|---|
| c=1 스트림당 | 12.7 | 11.1 (−12%) |
| c=8 집계 | 72.2 | 72.0 |
| c=32 집계 | 144.8 | 171.0 (+18%) |
| c=32 ITL p50 | 477 ms | 356 ms |
| 수용률 / 스텝당 토큰 | 20% / 2.39 | 41% / 2.23 |
단일 사용자는 손해, 다중 사용자는 이득. 부서 공용 서빙이면 k=3이 맞고, 개인 코딩 보조면 k=7이다. 현재는 k=3으로 두고 있다.
온도
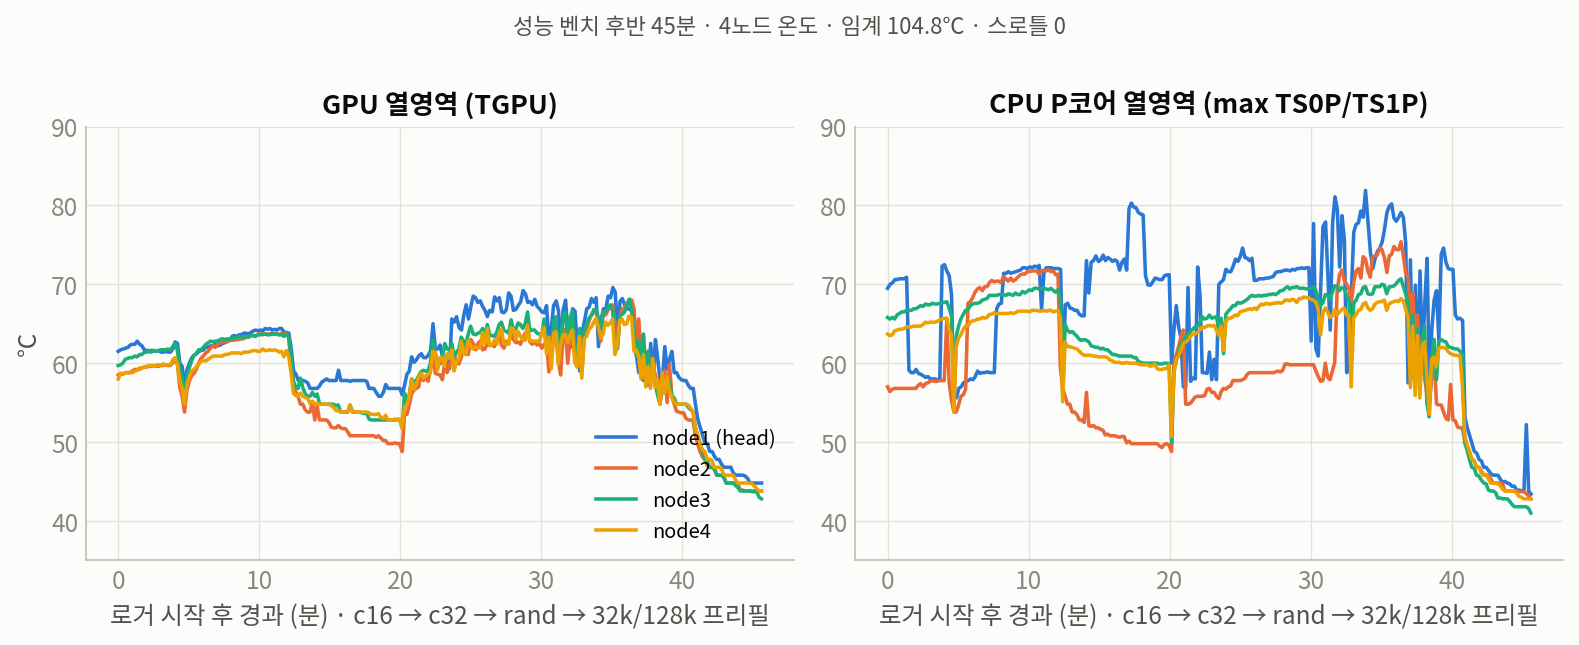
성능 벤치 후반 45분(동시 16 → 32 → 랜덤 → 32k/128k 프리필) 동안 4노드 10초 간격 로깅(GPU + ACPI 열영역 7개). 최고치: GPU 6366℃, GPU 존 6670℃, CPU P코어 존은 head 82℃ / 워커 68~75℃. 임계 104.8℃, 스로틀 플래그 0. head의 CPU가 워커보다 10℃ 높은 건 API 서버·스케줄러·벤치 클라이언트가 한 노드에 있어서다. 팬 RPM·PWM은 OS에 노출되지 않아 제어 불가.
2. 정확도 — lm-evaluation-harness 0.4.13
thinking OFF, temperature 0, 동시 16. 객관식은 두 경로로 나눠 돌렸다.
- 로그확률:
/v1/completions+ echo/logprobs, 원시 프롬프트. 생성이 없어 빠르다. chat template을 안 거치므로 공식 보고치와는 비교 불가 — 모델 간 상대 비교용. - 생성: chat 또는 completions로 답을 생성하고 정규식 추출.
| 태스크 | 경로 | n | 점수 |
|---|---|---|---|
| MMLU 5-shot | 로그확률 | 5,700 (과목당 100) | 87.9% |
| MMLU-Pro 5-shot CoT | 생성(chat) | 1,400 (카테고리당 100) | 77.6% (health 81) |
| KMMLU 5-shot | 로그확률 | 4,500 (과목당 100) | 64.5% |
| KMMLU-direct 5-shot | 생성 | 9,000 (과목당 200) | 66.0% |
| KorMedMCQA 5-shot | 생성 | 7,469 (전체) | 85.4% (의사 83.9 / 간호사 90.7 / 약사 88.1 / 치과의사 77.7) |
| MedQA 4-opt 0-shot | 로그확률 | 1,273 | 86.3% |
| MedMCQA 0-shot | 로그확률 | 4,183 | 76.4% |
| GSM8K 5-shot | 생성(chat) | 1,319 | 94.5% |
| HumanEval 0-shot | 생성(completions) | 164 | 75.0% pass@1 |
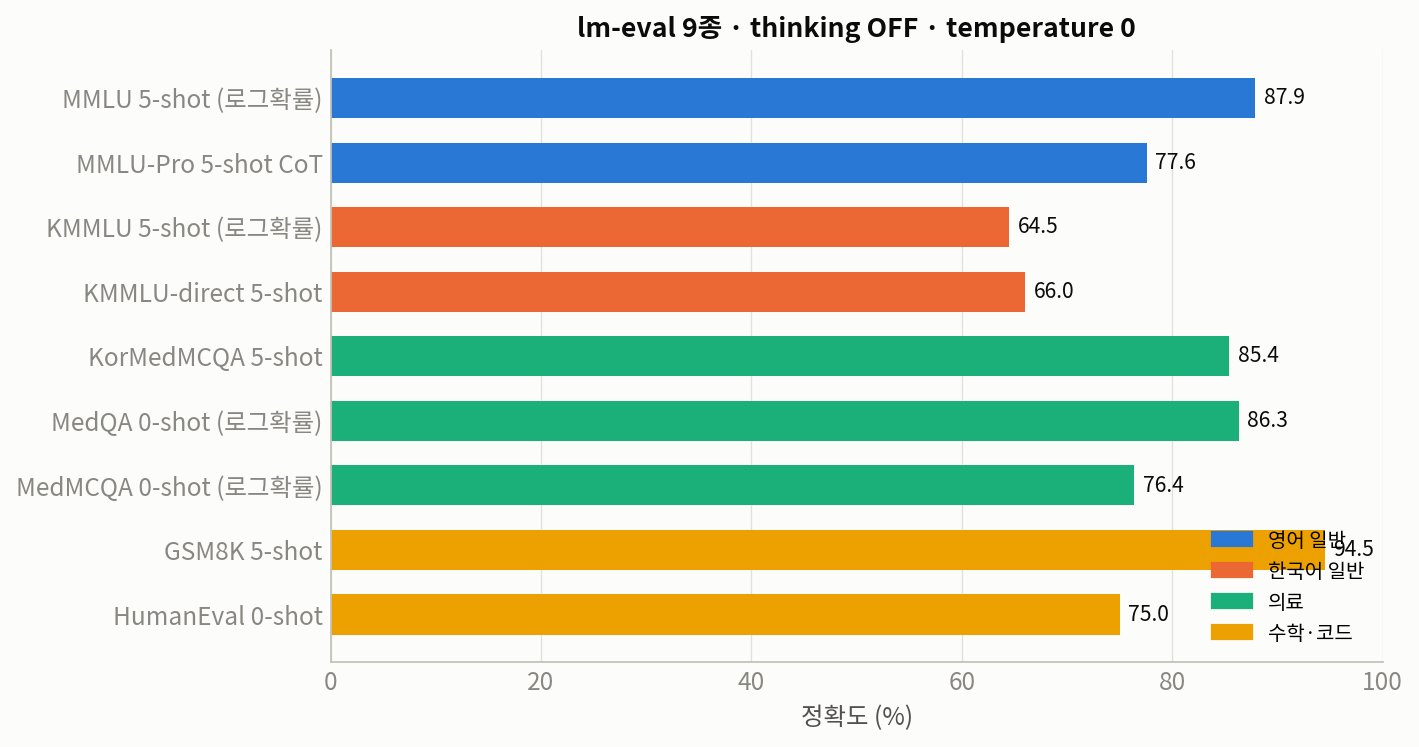
- 영어(MMLU 88) 대 한국어(KMMLU 64~66) 격차 22%p. 한국 의사 국시(KorMedMCQA)는 85로 상대적으로 높다 — 도메인 지식과 언어 능력은 다른 축이다.
- 소요: MMLU 2.5h(3.4 req/s), KMMLU 3h(1.5 req/s, 한국어 5-shot 프롬프트가 길다), 전체 약 9.5시간.
삽질 목록 (재현하려는 분을 위해)
- vLLM OpenAI API는
stop문자열 최대 4개. lm-eval의 generate_until 태스크(kormedmcqa, kmmlu_direct, humaneval…)는 5개를 보내 400이 난다.--gen_kwargs 'until=[...]'로 4개 이하를 명시해 덮어쓴다. - HumanEval을 chat 경로로 돌리면 17%가 나온다. 모델이 “# Solution\n\n```python …“로 답해 프롬프트 이어붙이기 채점이 깨진다. completions 경로(원시 프롬프트 이어쓰기, stop
\nclass \ndef \nif \nprint)로 75%. 채점 방식 확인 없이 숫자만 보면 안 된다. - HumanEval은
HF_ALLOW_CODE_EVAL=1필요. PubMedQA는 스크립트 기반 데이터셋이라 최신datasets에서 로드 실패 — 제외. - thinking ON/OFF는 서버 기동 인자(
--default-chat-template-kwargs)에 있다. 벤치 시작 전에 확인할 것. - 러너 스크립트를 ssh 한 줄 안에 heredoc으로 넣다가 따옴표가 깨져 한 시간을 날렸다. 스크립트는 파일로 복사해서 실행.
3. 생성 없는 결정 — ‘jevlike’ 실험
9월 15일 TypeSafe AI가 “System One 모델” Jev를 발표했다. 텍스트를 생성하지 않고 선택지에 대한 확률 분포만 돌려주는 결정 전용 API다. 폐쇄 API라 병원 데이터에는 쓸 수 없지만, 같은 발상은 어떤 LLM에서든 재현 가능하다: max_tokens=1로 요청하고 그 1토큰의 top_logprobs에서 선택지 라벨(A/B/C…)의 logprob만 읽어 정규화하면 된다. TypeSafe 자신도 이 방식의 어댑터 라이브러리를 배포한다.
이걸 GLM-5.3-Flash 위에 구현한 스크립트(jevlike)를 KorMedMCQA 의사 시험 test 435문항에 0-shot으로 돌렸다. 마침 같은 데이터셋으로 Jev를 독립 측정한 벤치(mahlernim/jev-korean-benchmark, 100문항 선별)가 있어 나란히 놓을 수 있었다.
| jevlike (GLM-5.3-Flash, 온프렘) | Jev (TypeSafe) | GPT-5.6 Luna (reasoning none) | |
|---|---|---|---|
| 문항 | 435 (test 전체), 0-shot | 100 선별 | 100 선별 |
| 정확도 | 85.3~86.0% (95% CI 82~89) | 80~82% | 88~89% |
| 지연 p50 | 417 ms (유휴), 858 ms (다른 사용자 1명 동시) | ~220 ms | ~1,000 ms |
| 출력 토큰 | 0 | 0 | 생성 |
같은 모델·같은 셋에서 lm-eval 5-shot 생성(83.9%)보다 0-shot logit 판독(85~86%)이 오히려 높았다. 첫 토큰 분포가 답을 이미 담고 있다.
확률은 쓸 만한가
미보정 상태에서 신뢰도(최대 확률) 구간별 정확도:
| 신뢰도 | n | 정확도 |
|---|---|---|
| 0.9–1.0 | 310 | 96% |
| 0.8–0.9 | 39 | 72% |
| 0.5–0.8 | 66 | 63~68% |
| <0.5 | 20 | 25~33% |
단조 증가한다. 고신뢰 구간(71%의 문항)은 96%라 그대로 쓸 수 있고, 중간 구간은 과신이라 temperature>1 보정 여지가 있다. 예측 분포는 AE 각 8090건으로 위치 편향은 보이지 않았다.
비결정성
temperature 0으로 두 번 돌렸는데 435건 중 15건(3.4%)의 선택이 달랐다. 정확도 차이는 0.7%p로 잡음 범위 안이지만, 경계선 문항이 이만큼 있다는 뜻이다. 배치 구성에 따른 커널 경로 차이나 드래프터 검증 경로, NVFP4/fp8 수치 오차가 후보다. 실무에서는 top1−top2 마진이 작은 케이스를 “보류"로 분류하는 게이트가 필요하다.
속도는 얼마나 빠른가 — 정직하게
같은 문항으로 같은 서버에서:
| 방식 | p50 |
|---|---|
| jevlike (max_tokens=1 + logprobs) | 457 ms |
| 생성 직답 (“한 글자만”) | 837 ms |
| thinking ON | 13.5 s (164~696 토큰) |
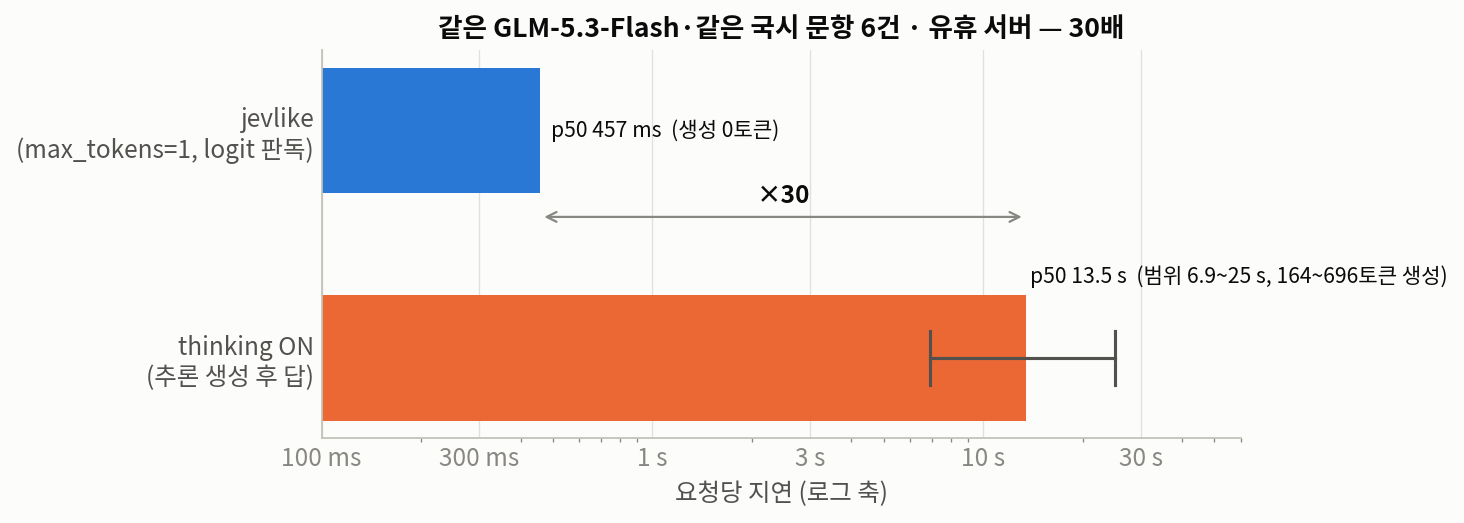
thinking OFF 직답 생성과의 차이는 디코드 2스텝, 1.8배다. “수십~수백 배"는 CoT 대비 수치다. jevlike의 가치는 속도보다 확률과 마진을 얻는다는 것, 출력 파싱이 없다는 것, 병렬화하면 처리량이 프리필 한도까지 선형으로 오른다는 것이다.
Jev에 대한 판단
hoax는 아니다 — 제3자가 호출해 벤치한 결과가 있다. 과장은 있다 — “hallucination 0%“는 스키마 제약의 정의상 결과이고, “200배"는 reasoning 모델 대비이며, 보정 주장에 신뢰도 다이어그램이나 ECE는 없다. 자사 블로그가 이 한계를 스스로 적어 두긴 했다. 온프렘이 필수인 환경에서는 어차피 선택지가 아니고, 위처럼 흉내 내면 정확도는 앞선다. 관심 있게 볼 부분은 보정 학습법(RLCD)이 공개되는지 정도.
남은 질문
- 한국어 단일 스트림 12 tok/s는 9월 초 같은 구성에서 측정한 32 tok/s와 3배 차이다. KV 24→16GiB, 클럭 캡, 동거 서비스 중 무엇인지 미해명.
- 드래프터 off 기준선, thinking ON 정확도, CUDA graph(
--enforce-eager해제) 가능 여부 — 각각 재기동 한 번씩이 필요하다. - jevlike: 실업무 100~200건 검증셋으로 temperature 보정, 마진 게이트, Score/Yes-No 프리미티브.
참고
- TypeSafe AI, Introducing System One Models & Jev
- mahlernim/jev-korean-benchmark — Jev·Luna KorMedMCQA 독립 측정
- Kweon et al. 2024, KorMedMCQA
- lm-evaluation-harness